26.700 parça bir makineye nasıl görünür: müzik arşivimi dizüstü GPU'sunda analiz ettim
Müzik arşivimin çoğu Türkçe ama hepsi değil. 78'lik plak aktarımlarından başlayan bir Türk sanat müziği koleksiyonu, bağlamalı halk ozanları, arabesk ve Anadolu rock var; çevresinde de Farsça ve Arapça söyleyenler, 80'lerin synth-pop'u, country, opera, metal ve oyun müzikleri. Bu arşivi hiç bir bütün olarak görmemiştim, sadece bir klasör listesi olarak biliyordum.
Her parçayı dizüstü bilgisayarımda açık kaynak ses modellerinden geçirdim, hepsinin sözlerini aradım ve sonucu iki iş için kullandım: arşivi tanımak ve ondan çalma listeleri yapmak. Hiçbir yayın servisi işin içinde değil; bilgisayardan dışarı çıkan tek veri söz aramalarıydı.
Parça
26.707
yaklaşık 2.200 albümde
Müzik
1.825 saat
arka arkaya 76 gün
Boyut
568 GB
parçaların %59'u FLAC, baytların %85'i
Tekil kayıt
23.687
kopyalar birleştirildikten sonra
Sanatçı
yaklaşık 400
20'si sürenin yarısını dolduruyor
Sözü olan parça
15.231
%57, en az 10 dilde
Veri nasıl çıktı
Analizi AudioMuse-AI yapıyor: bir medya sunucusunun yanında çalışan açık kaynak bir proje, burada sunucu Navidrome. İkisi de RTX A5000 Laptop GPU'lu (16 GB) bir dizüstünde Docker içinde çalışıyor. AudioMuse her parçanın sesini çözüp iki model çalıştırıyor:
- MusiCNN: etiketli Batı müziğiyle eğitilmiş küçük bir ağ. 200 değerlik bir gömme (embedding) ve rock, jazz, folk, female vocalists gibi 50 etiket için puan veriyor.
- CLAP: sesle metin açıklamalarını eşleştirerek eğitilmiş bir model. Metinle aynı uzayda 512 değerlik bir gömme veriyor, böylece arşivde bir cümleyle arama yapılabiliyor. AudioMuse bunu altı ruh hali puanı için de kullanıyor: dans edilir, agresif, mutlu, parti, rahat ve hüzünlü.
Paralel üç işçiyle analizin tamamı 13 saat 23 dakika sürdü, dakikada yaklaşık 33 parça. Modeller GPU'da çalıştı; sesi çözmek işlemcide kaldı ve asıl darboğaz oydu. AudioMuse aynı kaydı sesinden tanıyıp birleştiriyor, yani hem albümde hem iki derlemede geçen bir şarkı tek sayılıyor.
Sözleri gönüllülerin doldurduğu ücretsiz, zamanlı söz veritabanı LRCLIB'den aldım ve her parçanın yanına .lrc dosyası olarak kaydettim. Aynısını denerseniz işinize yarayabilecek birkaç şey:
/api/get, veritabanında olmayan bir parçayı dış kaynaklarda arıyor ve yük altındayken çoğu zaman 503 dönüyor./api/get-cachedsadece veritabanına bakıyor ve hemen cevap veriyor. Önce onu sorun./api/searchsık sık 503 veRetry-After: 1dönüyor. Üstel bekleme yerine tam o bir saniyeyi bekleyip tekrar denemek, betiğimi dakikada 2 parçadan 25 civarına çıkardı.- Bir sonucu ancak başlık ve sanatçı normalleştirildikten sonra tutuyorsa ve süre farkı 2 saniyeyi geçmiyorsa kabul edin. Zamanlı söz tek bir kayda aittir; aynı şarkının canlı ya da remiks hali başka zaman damgaları ister.
- Önce kendi etiketlerinize bakın. Bulunamayanların 843'ünde sanatçı etiketi yoktu ya da başlık yerine dosya adı vardı; arama
[Unknown Artist]ya da07. Ceza - Kolay Gelsiniçin yapılıyordu. Sanatçı olarak klasör adıyla tekrar arayınca bunların neredeyse yarısının sözü bulundu.
AudioMuse sözleri karşılaştırmak için onları GTE multilingual base modeliyle bir vektöre çeviriyor. Modelin int8 sürümüyle geliyor ve onu işlemciye sabitliyor. Arşivden 40 şarkı sözüyle mevcut sürümleri karşılaştırdım:
| Sürüm | Parça başına süre | fp32'ye kosinüs benzerliği (ortalama / en düşük) |
|---|---|---|
| int8, işlemci (hazır gelen) | 85 ile 102 ms | 0,949 / 0,891 |
| fp16, GPU | 7 ile 8 ms | 0,957 / 0,912 |
| fp32, GPU | 8 ile 11 ms | 1,000 / 1,000 |
Hem hazır gelen int8 model hem fp16 vektörleri fp32'den gözle görülür biçimde uzaklaştırıyor; GPU'da fp32 de aynı hızda olduğu için onu kullandım.
Arşivde ne var
Arşivi anlatmak için bu müzik için anlamı olan gruplara ihtiyacım vardı. Etiket tabanlı türler burada işe yaramıyor (aşağıda neden olduğu var), o yüzden sese göre grupladım: CLAP ve MusiCNN gömmelerinin birleşimine uygulanan k-means 60 küme verdi, ben de her kümedeki sanatçılara bakarak bunları elle dokuz gruba ayırdım.
Süre olarak en büyük grup Türk sanat müziği, ama parça sayısı poptan az: bir sanat müziği kaydı çoğu zaman altı yedi dakika sürüyor, bir dans şarkısının remiksi üç. En uç örnek Kani Karaca: 173 ilahi ve mevlid kaydı toplam 78 saat tutuyor, kayıt başına ortalama 27 dakika.
Zeki Müren tek başına 110 saat, arşivin %6'sı. İkinci sıradaki Inna'nın yeri çoğunlukla remikslerden geliyor: birkaç yüz şarkısı olan bir sanatçıdan 1.270 parça.
Bu grafik, müziğin ne zaman kaydedildiğinden çok nasıl yayımlandığını anlatıyor. 1950 öncesine etiketli sadece 34 parça var, oysa sanat müziği koleksiyonunun büyük kısmı 1930'larla 1950'ler arasında 78'lik plaklara kaydedildi. Bu kayıtlar bana CD ve dijital yeniden baskılarla geldi, dolayısıyla yılları da baskı yılı: sanat müziği grubunun ortanca yılı 2004. 2010'lardaki zirve aynı etkiye ek olarak gerçekten yeni müzik, genişletilmiş baskılar ve remiks albümlerinden geliyor. Eski müziğin kayıt tarihini arıyorsanız bakılacak yer etiketler değil.
Arşivin haritası
Gömmeler 712 boyutlu. UMAP bunları ikiye indiriyor ve benzer duyulan kayıtları yan yana getiriyor. Her nokta bir kayıt, renk grubunu gösteriyor; etiketler 60 kümeden bazılarını işaretliyor.
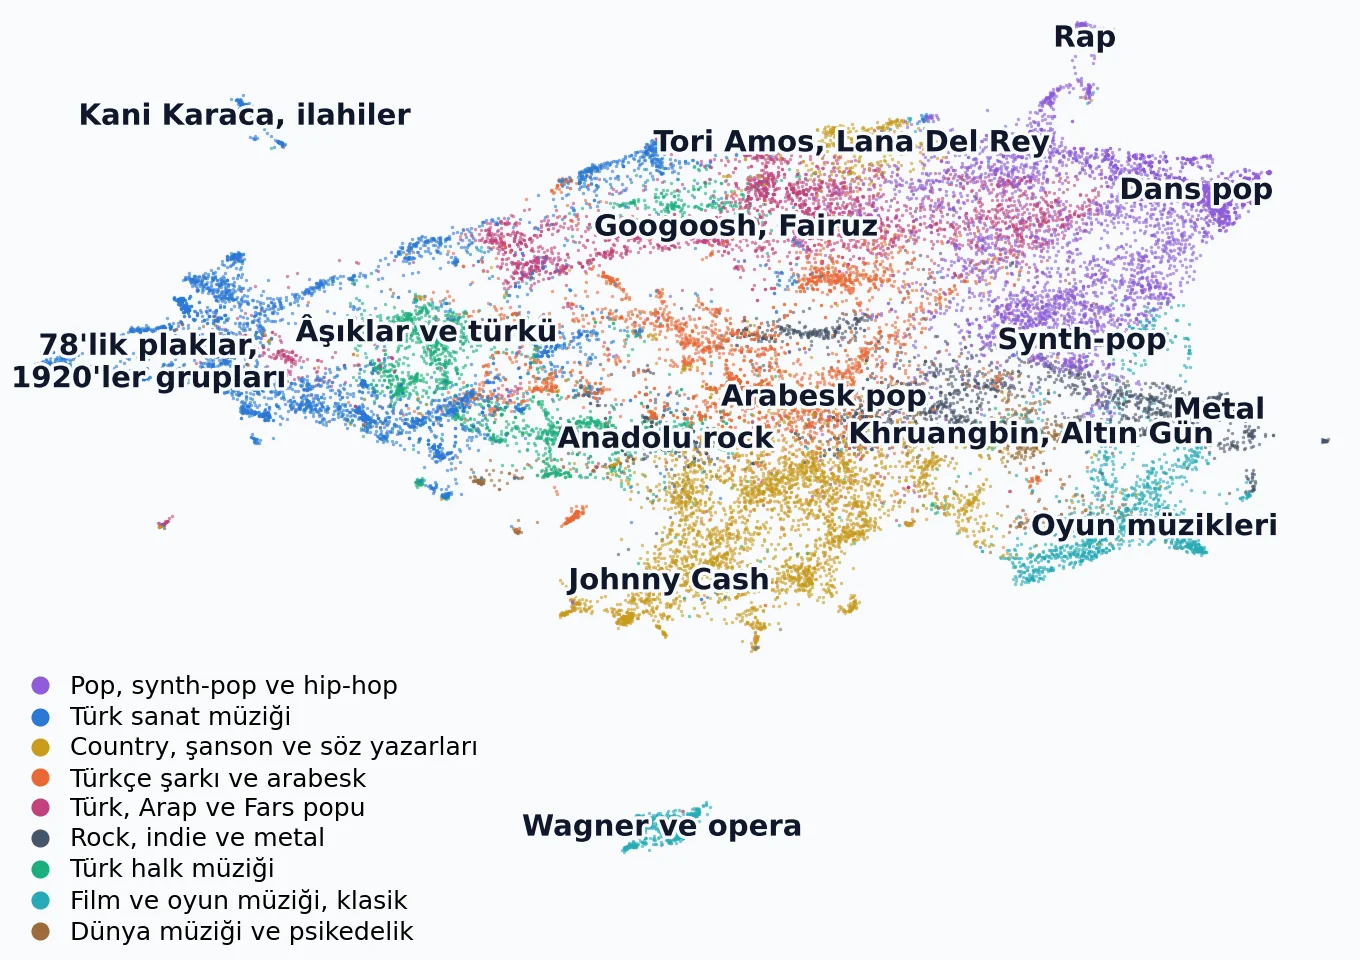
Harita kabaca eskiden yeniye ve akustikten elektroniğe doğru uzanıyor. Sanat müziği solu dolduruyor; en uç kenarında Münir Nurettin Selçuk'u 1920'lerin Amerikan grupları ve şarkıcılarıyla (Fletcher Henderson, Eddie Cantor) ve BioShock müziklerindeki eski plaklarla yan yana koyan bir küme var. Ortak noktaları müzik değil, taş plağın sesi. Halk müziği onun yanında, arabesk ve Orta Doğu popu ortada, pop ve synth-pop sağda. İki grup kendi adasında: en üstte rap, en altta Wagner ile Viyana Filarmoni. Arşivde Götterdämmerung çalan bir orkestraya benzeyen başka hiçbir şey yok.
Sözler: kimin sözü var, hangi dilde
LRCLIB bazı müzikler için çok iyi, bazıları için neredeyse boş. Gruplara ayırınca fark büyük:
Country, şanson ve söz yazarı parçalarının dörtte üçünün sözü var, çoğu zamanlı. Sanat müziğinde bu oran altıda bir, halk müziğinde üçte bir. İlk turda 12.713 parçaya .lrc dosyası yazıldı; bulunamayanların üstünden geçen, adları düzeltilmiş ve remiks ile canlı kayıtlar için düz söze izin veren ikinci tur, kalanların yaklaşık dörtte birini daha buluyor. Eski Türk repertuvarı LRCLIB'de büyük ölçüde eksik.
Sözü olan parçaların %86'sı Türkçe ve İngilizce. Farsçanın neredeyse tamamı Googoosh, Arapçanın çoğu Nancy Ajram ve Fairuz, İbranicenin çoğu Ninet Tayeb. İspanyolcanın çoğu, bütün bir İspanyolca albüm yapan Inna.
Modeller ne duyuyor
MusiCNN, çoğu Batı müziği için Last.fm kullanıcılarının verdiği etiketlerle eğitildi. Her parça için en yüksek puanlı etiketini aldım:
Müzik Batılıysa etiketler yerinde: rock rock, country country, film müzikleri ambient. Değilse model bildiği en yakın şeye uzanıyor. Türkçe şarkı ve arabesk grubunun neredeyse yarısı "rock". Sanat müziği beş parçadan birinde jazz, birinde rock, altıda birinde blues. Halk müziği "folk" etiketini alıyor ama sadece beşte iki oranında. Modelin kendi açısından bunların hiçbiri yanlış değil, sadece makam için bir kelimesi yok. Bu etiketlerle liste adlandıran ya da örnekleyen her araç için önemli; AudioMuse ikisini de yapıyor ve bu yüzden bu arşiv için kendi listelerinin adları Rock_Pop_Electronic_Medium_Happy_Party gibi çıktı.
Ruh hali puanları ise CLAP'ten geliyor. Hepsi dar bir aralıkta, o yüzden grafik her grubun kütüphane ortalamasından ne kadar uzak olduğunu standart sapma cinsinden gösteriyor:
Çoğu beklendiği gibi, bu da iyiye işaret: en dans edilir ve en parti havasında olan pop, en az mutlu olan film müzikleri, en rahat olan psikedelik ve dünya müziği grubu. Beklemediğim iki sonuç var. En hüzünlü grup, ünü hüzünden gelen arabeski geride bırakıp country ve şanson çıktı. Halk müziği de arşivin en az rahat grubu. İkincisinin muhtemel sebebi: büyük kısmı mikrofona yakın, sert çalınan bir bağlama ve tek bir ses.
Ton tahminlerini dışarıda bıraktım. Analiz her parça için bir ton ve majör ya da minör bilgisi veriyor, ama makam müziği majör ve minör dizilere dayanmıyor; bu arşivin yarısı için cevap zorlama olurdu.
Veriden çalma listelerine
AudioMuse çalma listelerini arşivden alınan bir örneklemi kümeleyip en yüksek puanlı kümeleri tutarak yapıyor. Birkaç liste önermek için makul bir yol, ama arşivin tamamını kapsamıyor: 50 liste istediğimde 23.687 kayıttan 1.871'i listelere girdi. Üstüne tür sorunu da eklenince listeleri yukarıdaki aynı 60 kümeden kendim yaptım:
- Her kümede kayıtlar merkeze uzaklığa göre sıralanıyor, en tipik olanlar başa geliyor; sanatçı başına en çok 8 şarkı, liste başına en çok 100 şarkı; aynı şarkının başka albümdeki kopyası atlanıyor.
- En çok parçası olan 30 sanatçı için radyolar: sanatçının bütün vektörlerinin ortalaması alınıp ona en yakın kayıtlar listeleniyor; sanatçının kendisinden en çok 15, diğerlerinden 5'er şarkı. Cem Karaca radyosu Erkin Koray, Moğollar ve David Bowie getiriyor; Googoosh radyosu Nesrin Sipahi, Fairuz ve Nilüfer.
- CLAP için İngilizce cümle olarak yazılmış 20 tema. "1980s synthpop with analog synthesizers" OMD, The Human League ve Münchener Freiheit getiriyor. "Sad turkish arabesque with string orchestra" ise Abel Korzeniowski ve Inon Zur'un film müziklerini getirdi: yaylılar ve hüzün var, ama arşivdeki arabeskten hiçbiri yok. CLAP'in de MusiCNN'le aynı kör noktası var.
Her liste, arşivin kökündeki bir klasörde, yolları o klasöre göreli (../Sanatçı/Albüm/parça.flac) bir .m3u8 dosyası; böylece aynı dosyalar hem dizüstünde hem telefondaki arşiv kopyasında çalışıyor. Kısa bir betik her listeye, en sık geçen dört albümünden bir kapak yapıyor.
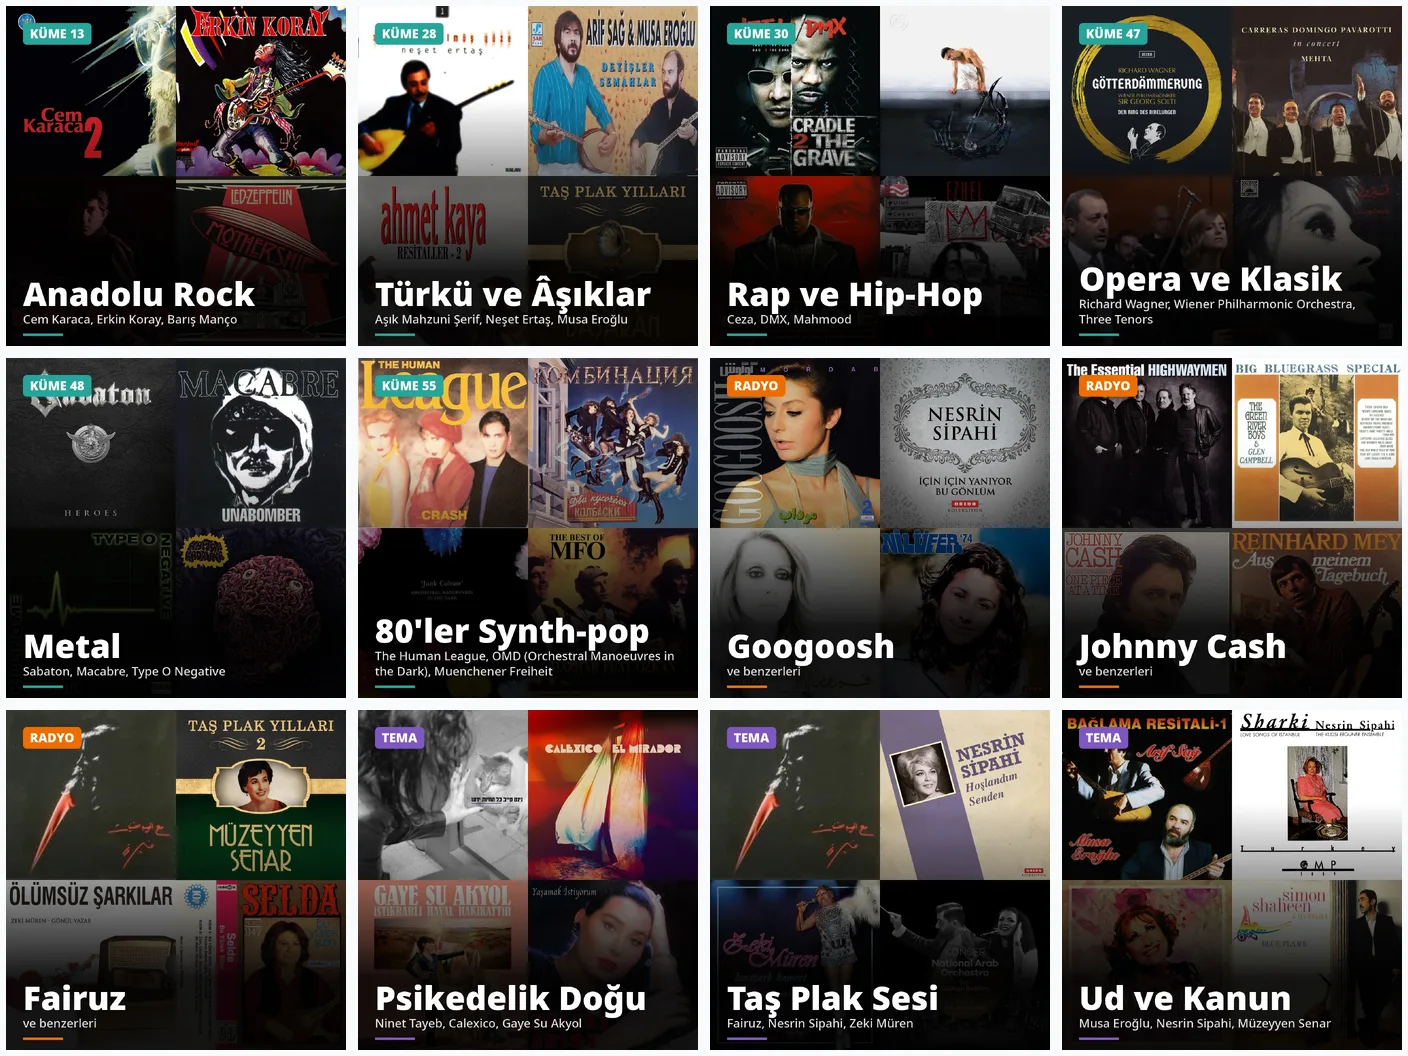
Sözler bu listelerde henüz kullanılmıyor. Söz vektörleri en çok dili ve konuyu taşıyor; onlar dile ve konuya göre gruplanmış ayrı bir liste setine gidecek.
Tüm ayarlar
- AudioMuse-AI 3.6.4 (
latest-nvidiaimajı), Navidrome 0.64.2, PostgreSQL 15; üç analiz işçisi; CUDA sağlayıcılı ONNX Runtime; Whisper kapalı. - Analiz: 26.705 dosya, 48.203 sn; 23.687 tekil kayıt.
- LRCLIB: önce başlık, sanatçı, albüm ve yuvarlanmış süreyle
/api/get-cached, sonra parantezsiz başlıkla, parça sanatçısı ve albüm sanatçısı için/api/search. Normalleştirilmiş başlık ve sanatçı tutuyor ve süre farkı en çok 2 sn ise kabul; zamanlı söz öncelikli. Üç iş parçacığı,Retry-After'a uyarak. - Söz vektörleri: GTE multilingual base, Hugging Face'teki onnx-community fp32 ONNX dışa aktarımı, ilk belirteçle havuzlama, birim uzunluk, en çok 512 belirteç.
- Kümeler: CLAP (512) ve 0,7 × MusiCNN (200), her biri ortalamadan arındırılıp birim uzunluğa ölçeklenmiş; RAPIDS cuML KMeans, k = 60, 5 başlatma. Grupların kümelere atanması elle.
- Harita: cuML UMAP, kosinüs ölçütü, 30 komşu, en küçük mesafe 0,25, aynı vektörler.
- Ruh halleri: AudioMuse'un CLAP tabanlı puanları; grup ortalaması eksi kütüphane ortalaması, bölü kütüphane standart sapması.
- Diller: Arap, İbrani, Kiril ve Yunan alfabeleri karakter aralıklarıyla; Farsça ile Arapça پ, چ, گ ve ی gibi harflerle; Latin alfabeli diller sık geçen kısa kelimeler sayılarak; en az 40 harf ve 5 eşleşme.
- Yıllar: albüm yılı etiketi, yoksa klasör adındaki yıl.